KI-Assistent-System zur Produktdatenpflege: Laptop zeigt Interface mit Checklisten, umgeben von technischen Dokumenten, Produktzeichnungen und Metallflanschen mit Produktdatenblatt
KI PIM KI PIM

Steffi Favetto 10 Minuten

Boost für die Produktdatenpflege: Was KI und PIM-System gemeinsam leisten

KI und PIM-System beschleunigen die Produktdatenpflege dort, wo heute viel gleichförmige manuelle Arbeit anfällt: beim Einlesen von Lieferantendaten, bei Produkttexten und Übersetzungen und bei der Prüfung der Datenqualität. Verlässlich arbeitet die KI aber erst mit einem PIM-System, weil ihre Ergebnisse dort geprüft, freigegeben und an alle Kanäle ausgespielt werden.

Die Produktdatenpflege wächst mit jedem Lieferanten, Kanal und Markt

Neue Artikel kommen bei vielen Herstellern und Händlern als Excel-Liste direkt vom Lieferanten, oft mit PDF-Datenblättern im Anhang. Jemand aus der Produktdatenpflege überträgt die Werte, ordnet jeden Artikel einer Kategorie zu und schreibt Texte für Shop, Marktplatz und Katalog. Sobald ein weiteres Land dazukommt, gehen die Texte zur Übersetzung raus und kommen per Mail zurück. Das frisst Zeit, ist umständlich und fehleranfällig.

Ein PIM-System bringt Ordnung in diese Arbeit, weil alle Produktdaten an einer einzigen Stelle liegen. Werte abgleichen oder Produktbeschreibungen schreiben muss das Team aber häufig noch selbst. KI-Werkzeuge versprechen genau dafür Tempo. Setzt ein Unternehmen nur eines von beiden ein, zeigt sich allerdings schnell, wo es nicht weitergeht.

KI braucht eine zentrale Datenbasis, das PIM-System braucht Tempo

Beide Ansätze bringen für sich schon etwas, aber erst zusammen entlasten sie die Produktdatenpflege wirklich.

Ansatz Was er leistet Die Grenzen
PIM-System allein zentrale Datenhaltung, einheitliches Datenmodell, Freigabe-Workflows, Ausspielung an alle Kanäle Anreicherung, Texte, Übersetzungen und das Einlesen von Lieferantendaten bleiben Handarbeit. Bei großen Sortimenten wird die Pflege zum Engpass.
KI allein, etwa Textgeneratoren oder Werkzeuge, die Daten im Feed anreichern schnelle Texte, Übersetzungen, Werte aus Dokumenten auslesen Die Daten liegen verstreut in Excel, ERP und Shop. Die Ergebnisse fließen nicht geordnet zurück, und niemand gibt sie nachvollziehbar frei. Fehler entstehen in jedem Kanal einzeln.
PIM-System und KI zusammen Die KI arbeitet mit den zentralen Daten im PIM. Was sie erzeugt, landet dort als Vorschlag, durchläuft die Freigabe und geht einheitlich an alle Kanäle. Datenmodell, Zuständigkeiten und Qualitätsregeln müssen vorher geklärt sein.

Ein Textgenerator ohne PIM spart deshalb weniger Zeit, als es zunächst scheint: Jemand muss seine Ergebnisse weiterhin von Hand in jedes System übertragen und dort aktuell halten.

Die Kombination ist der Schlüssel. Das hat vier Gründe:

  • Kontext: Die KI kennt aus dem PIM das Datenmodell, die Pflichtattribute je Produktklasse, das Glossar und die Vorgaben zur Tonalität. Deshalb passen ihre Vorschläge von Anfang an zur Struktur.
  • Rückfluss: Was die KI erzeugt, landet als Attributwert oder Text an der richtigen Stelle im PIM und nicht in einer weiteren Excel-Datei.
  • Kontrolle: Rollen und Workflows im PIM regeln, dass ein Mensch jeden KI-Vorschlag prüft, bevor er ihn freigibt.
  • Einmal gepflegt, überall genutzt: Eine freigegebene Änderung geht aus dem PIM an Shop, Marktplätze, Kataloge und auch an KI-Assistenten, die Produkte vergleichen.
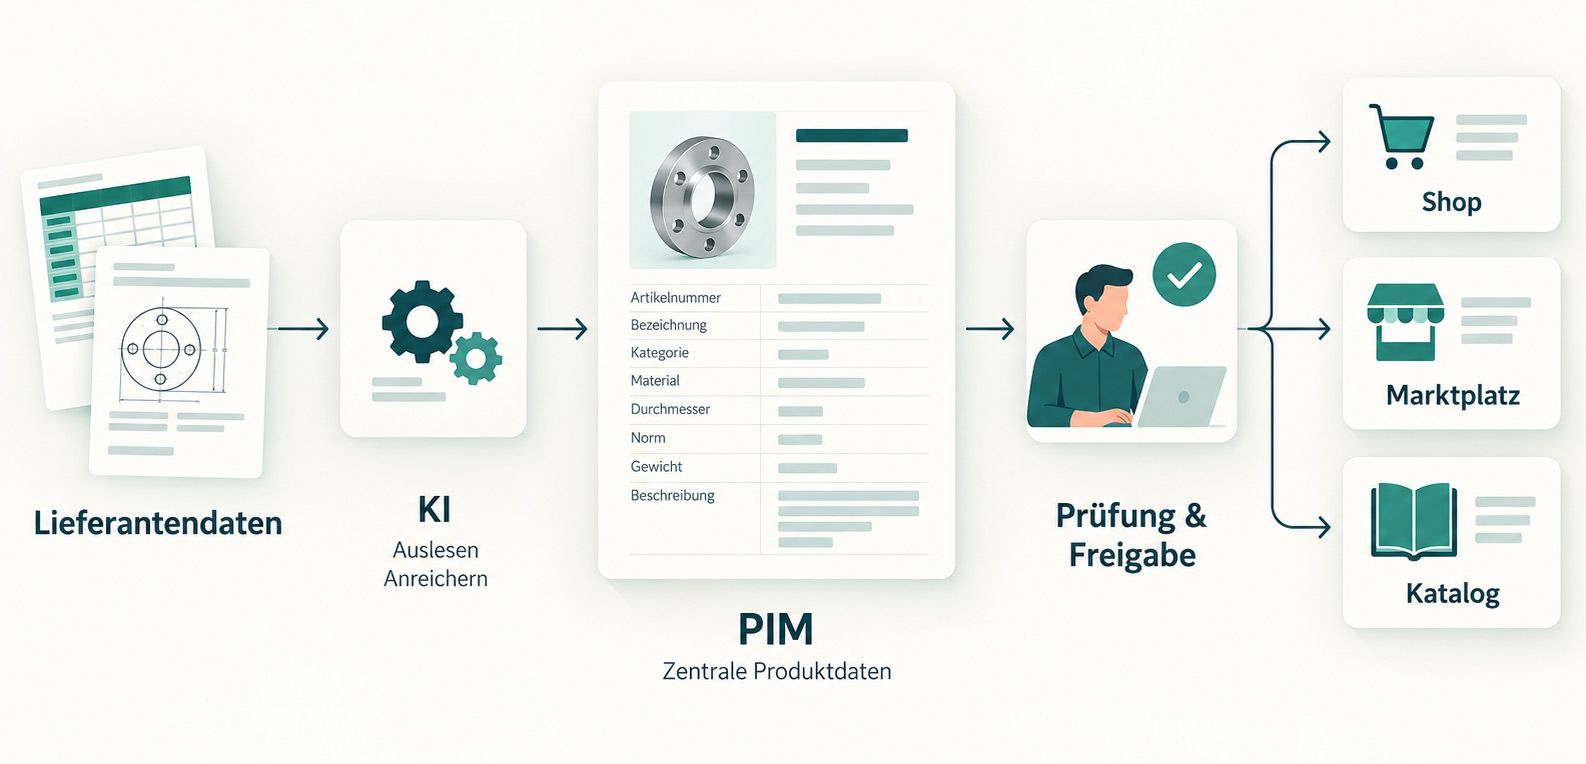
Prozessablauf einer Produktdatenverwaltung: Lieferantendaten und KI-Auslesen speisen in PIM-System mit Produktdetails ein, gefolgt von Prüfung und Freigabe, dann Verteilung auf Shop, Marktplatz und Katalog

Beim Lieferanten-Onboarding spart KI die meiste manuelle Arbeit

Am meisten Zeit kostet in vielen Unternehmen das Onboarding neuer Artikel, also der Weg von der Lieferantenliste bis zum vollständigen Datensatz im PIM. Zwei Schritte davon kann die KI übernehmen. Sie liest Werte aus Datenblättern und Excel-Listen aus und ordnet sie den Attributen im PIM zu. Außerdem schlägt sie vor, in welche Produktklasse ein Artikel gehört, etwa nach den Klassifizierungsstandards ETIM oder ECLASS, die viele Branchen für technische Produkte nutzen.

Angenommen, ein Hersteller bekommt 2.000 neue Artikel als Excel-Liste mit PDF-Datenblättern. Die KI liest die Attribute aus, schlägt je Artikel die Klasse vor und erstellt Textentwürfe auf Deutsch und Englisch. Die Produktdatenpflege tippt nichts mehr ab, sondern prüft nur noch die Fälle, in denen die KI unsicher ist oder Werte nicht zusammenpassen, und gibt die übrigen frei.

Kann KI Produktdaten aus PDF-Datenblättern auslesen?

Ja, sofern die Datenblätter Text enthalten und im PIM feststeht, welche Attribute ein Artikel haben muss. Die KI erkennt dann zum Beispiel, dass „Ø 40 mm“ in das Feld für den Durchmesser gehört und „V2A“ ein Wert für das Material ist.

Produkttexte und Übersetzungen entstehen aus den Attributen im PIM

Sind die Attribute vollständig im PIM hinterlegt, ist die KI in der Lage, daraus Entwürfe für Produkttexte, Titel und Bullet Points zu erstellen. Und das je Kanal. Für den Shop wird es eine ausführliche Beschreibung, für den Marktplatz eine Stichpunktliste in der vorgegebenen Länge und für den Katalog ein kurzer Text. Das hilft vor allem bei Artikeln, die bisher gar keinen Text hatten, weil sich der Aufwand für die manuelle Arbeit nicht gelohnt hat.

Bei der Übersetzung arbeitet die KI mit dem Glossar aus dem PIM. Steht dort, dass ein Fachbegriff im Französischen immer gleich übersetzt wird, hält sie sich daran. Neue Märkte lassen sich so schneller mit Daten versorgen, und die Fachleute in den Ländern prüfen nur noch, statt jeden Text einzeln anzufordern.

KI prüft die Datenqualität, bevor Fehler im Shop landen

Bevor ein Artikel in die verschiedenen Kanäle geht, kann die KI ihn gegen die Qualitätsregeln im PIM prüfen. Sie findet leere Pflichtattribute, widersprüchliche Werte und Ausreißer wie eine Schraube mit 400 Kilogramm Gewicht ebenso wie doppelte Artikel. Die Regeln dafür wurden im PIM hinterlegt, zum Beispiel welche Attribute je Produktklasse Pflicht sind. Die KI wendet sie auf viele Artikel gleichzeitig an und meldet, was auffällt. Entscheiden, was korrigiert wird, muss weiterhin ein Mensch, aber die Suche nach Fehlern kostet keine Stunden mehr. Das entlastet auch die Teams der verschiedenen Fachbereiche.

KI-Assistenten brauchen strukturierte Produktdaten

Wer ein passendes Produkt sucht, fragt heute auch ChatGPT, Gemini oder Copilot. Diese KI-Assistenten suchen und vergleichen Produkte, gekauft wird in Deutschland aber noch im Shop des Anbieters. Für den Vergleich brauchen sie strukturierte Attribute, denn Maße oder Kompatibilität lesen sie aus Fließtext nur unzuverlässig heraus.

Das PIM-System wird damit zur Quelle für Menschen und für Maschinen. Welche Angaben dafür nötig sind und wo sie entstehen, beschreibt der Beitrag „Welche Produktdaten KI-Agenten brauchen“.

Vor der KI kommen Datenmodell und Zuständigkeiten

KI verstärkt, was im Datenmodell angelegt ist, auch dessen Fehler. Fehlt ein Pflichtattribut, erzeugt die KI tausend Texte ohne diese Angabe. Sind Werte uneinheitlich gepflegt, übernimmt sie die Uneinheitlichkeit in jeden Kanal. Deshalb sind vor der Technik drei Fragen zu klären:

  • Wer welche Attribute verantwortet
  • Wer KI-Vorschläge freigibt
  • Welches System welche Angabe führt

Jeder Anwendungsfall setzt dazu etwas voraus, das im PIM geklärt sein muss:

Anwendungsfall Was vorher geklärt sein muss
Attribute aus Datenblättern auslesen ein sauberes Attributmodell mit Pflichtfeldern je Produktklasse
Klasse vorschlagen ein festgelegter Klassifizierungsstandard, etwa ETIM oder ECLASS
Produkttexte schreiben Vorgaben zur Tonalität und ein Freigabe-Workflow
Übersetzen ein Glossar mit festen Übersetzungen für Fachbegriffe
Datenqualität prüfen Qualitätsregeln, die im PIM hinterlegt sind

Der Einstieg gelingt mit einem klar abgegrenzten Anwendungsfall: Zuerst gehören die Produktdaten zentral in ein PIM-System, mit einem Datenmodell, auf das sich alle beteiligten Fachbereiche geeinigt haben. Dann braucht es strukturierte Prozesse, Workflows und Quality Gates. Danach beginnt der Einsatz der KI mit einem einzigen, klar abgegrenzten Anwendungsfall. Für den Start eignet sich das Lieferanten-Onboarding, weil dort die meiste manuelle Arbeit steckt und sich der Unterschied schon bei den ersten Lieferungen zeigt.

Die menschliche Freigabe gehört von Anfang an dazu, weil das Team den Vorschlägen der KI erst vertraut, wenn es sie eine Weile geprüft hat, und weil Fehler sonst ungeprüft in die Kanäle gehen. Wenig hilfreich ist es dagegen, die KI gleich für alle Aufgaben einzuführen, solange das Datenmodell noch offen ist. Dann entstehen viele Texte und Werte, die später aufwendig korrigiert werden müssen.

Praxistipp: Eine Woche lang notiert die Produktdatenpflege, bei welchen konkreten Aufgaben noch manuelle Arbeiten oder Recherchen notwendig sind und wie lange das jeweils dauert. Die Aufgabe mit dem größten Aufwand ist meist der beste erste Anwendungsfall für KI.

KI im PIM-System lohnt sich, wenn das Datenmodell steht

Ein PIM-System sorgt dafür, dass alle Produktdaten an einer Stelle liegen und nach festen Regeln gepflegt werden. Die KI beschleunigt die Arbeit an genau diesen Daten, vor allem beim Einlesen von Lieferantendaten, bei Produkttexten und Übersetzungen und bei der Qualitätsprüfung. Damit die KI dabei keine Fehler vervielfältigt, sollten Datenmodell, Zuständigkeiten und Qualitätsregeln vorher geklärt sein.

Wie das im Alltag aussieht, zeigen Anja Barz (PIM Consultant) und Daniela Baron (Head of PIM & Digital Strategy) am 10. November 2026 im kostenfreien Live-Webinar „PIM + KI: Wie Sie Produktdaten skalieren, ohne Ihr Team zu vergrößern“. Am Beispiel von Perfion PIM gehen sie den Weg von verstreuten Lieferantendaten bis zu fertigen Inhalten für die Kanäle Schritt für Schritt durch.

Häufige Fragen zu KI und PIM-System

Nein, denn die KI erzeugt nur Vorschläge und verwaltet selbst keine Produktdaten. Im PIM-System ist festgelegt, welche Attribute ein Artikel hat, wer sie pflegt und freigibt und welcher Kanal welche Daten bekommt. Fehlt diese zentrale Ablage, landen KI-Ergebnisse in einzelnen Dateien oder direkt im Shop, und später weiß niemand mehr, welcher Stand gilt.

Nein, solange die Texte für die Lesenden hilfreich sind. Google bewertet laut seinem Leitfaden zu KI-generierten Inhalten (2023) die Qualität eines Inhalts und nicht, wie er entstanden ist. Gegen die Spamrichtlinien verstößt Automatisierung erst, wenn sie vor allem das Ranking manipulieren soll. Für Produkttexte heißt das, dass Varianten unterscheidbare Angaben brauchen, denn Texte, die sich nur im Produktnamen unterscheiden, helfen weder Kund*innen noch der Suche.

In der Regel nein, Stand Oktober 2026. Die Transparenzpflichten aus Artikel 50 der KI-Verordnung (EU) 2024/1689 gelten seit dem 2. August 2026 und betreffen vor allem Deepfakes und KI-Texte, die über Angelegenheiten von öffentlichem Interesse informieren. Produkttexte gehören nicht dazu, und Texte, die ein Mensch geprüft und redaktionell verantwortet hat, sind ausdrücklich ausgenommen. Auch deshalb lohnt sich die Freigabe im PIM.